无限画布中表情调节怎么用
无限画布中表情调节怎么用 关键参数
| 用途与边界 | 只改脸:眉、眼、嘴与面部肌肉,以及匹配的眼神与细微头部微表情;人物身份、五官特征、肤色、发型、服饰、姿态、构图、光影、背景都与原图一致;与在提示词里写「微笑」不同——情绪种类与强度在点阵上定,并附灰白 3D 素模头像作参考 |
|---|---|
| 入口 | 画布上点选目标人物图片节点 → 节点下方工具条点【表情调节】;面板左上角【角色1】即源图本身,默认用整张图,无需先框人脸 |
| 点阵读法 | 5×5 表情控制器:纵向五族表情(喜、吃惊、困惑、怒、悲伤),横向五列强度(左【轻微】→右【强烈】);白色圆钮可拖动或点选,松手吸附最近格子;左素模实时换表情,底部【情绪定位】显示情绪名;例如「喜」行:淡然自若→浅然莞尔→含情凝望→满眼宠溺→欣然愉悦,「悲伤」行:疲惫失神→强忍悲戚→隐忍心伤→触景伤情→默然垂泪 |
| 生成与结果 | 点面板右上角【生成】→ 画布新增节点并自动出图,标题带本次情绪(如「表情调节-默然垂泪」);原图保留可并排对比,不满意回到原图换一格重生成;画面中多张人脸会整体一起调整;素模头像不会被画进结果 |
人物的长相、姿态、服装、光线、背景都满意了,唯独表情不对——回头改提示词重出一张,往往连人带景一起变。【表情调节】只改脸:眉、眼、嘴与面部肌肉,以及匹配的眼神与细微头部微表情,其余一切保持原样。本文讲清三步操作、五族表情与强度的读法,以及「表情对了但人变样」时的收敛办法。
一、什么时候用它
人物的长相、姿态、服装、光线、背景都已经满意了,唯独表情不对:该笑的时候太板,该崩溃的时候太克制,或者一组图里每张的情绪浓淡不一致。
这种时候不必回头改提示词重出一张——重出往往连人带景一起变了。【表情调节】只改脸:眉、眼、嘴与面部肌肉,以及与之匹配的眼神和细微的头部微表情;人物身份、五官特征、肤色、发型、服饰、姿态、构图、光影和背景都要求与原图保持一致。
它和在提示词里写「微笑」的区别在于:情绪的种类和强度是在点阵上定出来的,还会附上一张灰白 3D 素模头像作为表情参考一起交给模型,而不是靠一句文字让模型自行拿捏分寸。
二、操作步骤
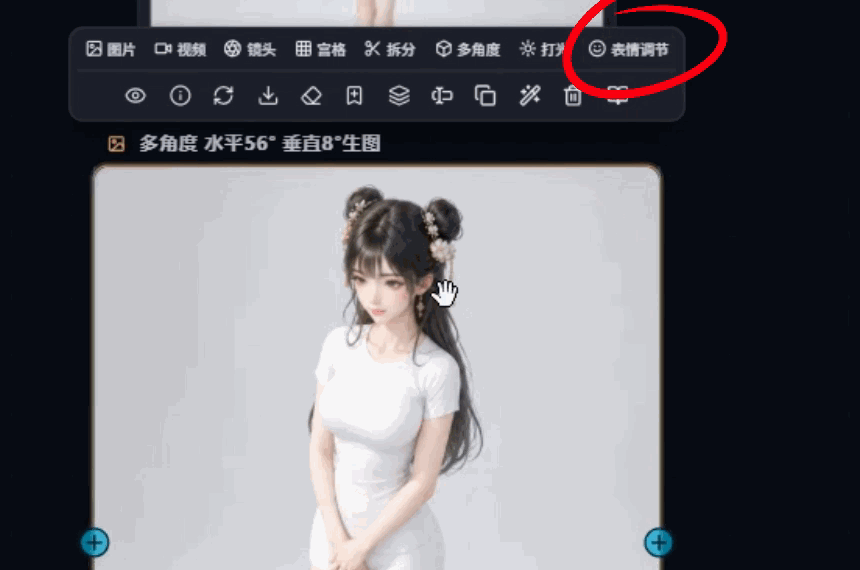
1. 选中图片节点,点工具条里的【表情调节】
在画布上点一下目标人物图片节点,节点下方浮出的工具条里点【表情调节】(鼠标停上去会显示「表情调节」)。
面板打开后,左上角会出现一个【角色1】的小头像——它就是这张源图本身。面板默认拿整张图去做表情调节,不需要你先把人脸框出来。
2. 在点阵上选情绪与强度
面板右边是一块 5×5 的表情点阵,也就是表情控制器:
- 纵向五行是五族表情:从上到下依次为喜、吃惊、困惑、怒、悲伤;
- 横向五列是强度:左端【轻微】,右端【强烈】,越往右情绪越浓;
- 白色圆钮是当前选择,可以直接按住拖动,靠近它的点会跟着变深变大,松手会吸附到最近的格子上;也可以直接点某一个点。
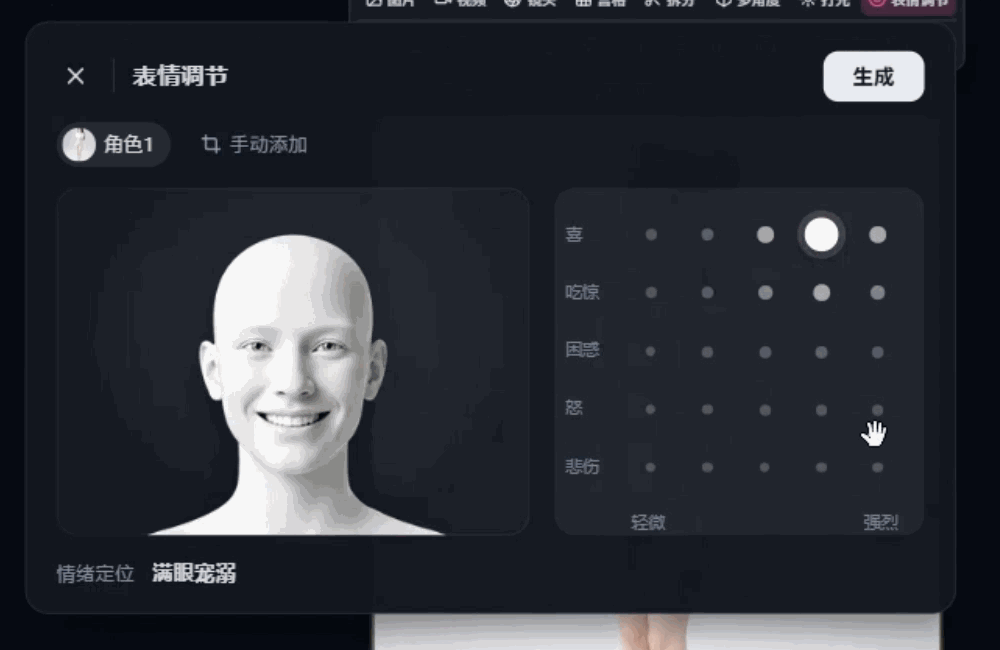
每挪一格,左边的灰白 3D 素模头像会立刻换成该情绪的参考表情,面板底部的【情绪定位】同时显示这一格的情绪名——比如「淡然自若」「满眼宠溺」「难以置信」「默然垂泪」。先看着左边这张脸挑,比对着文字猜要准得多。
25 个格子各自对应一个情绪定位,同一族里从轻到重是连续过渡的。以「喜」这一行为例,从左到右是淡然自若 → 浅然莞尔 → 含情凝望 → 满眼宠溺 → 欣然愉悦;「悲伤」这一行则是疲惫失神 → 强忍悲戚 → 隐忍心伤 → 触景伤情 → 默然垂泪。想要「忍着没哭出来」而不是「嚎啕大哭」,就往左收一两格。
3. 点【生成】,结果落在新节点上
点面板右上角【生成】,画布上会新增一个节点并自动开始出图,节点标题写着这次选的情绪,例如「表情调节-默然垂泪」。
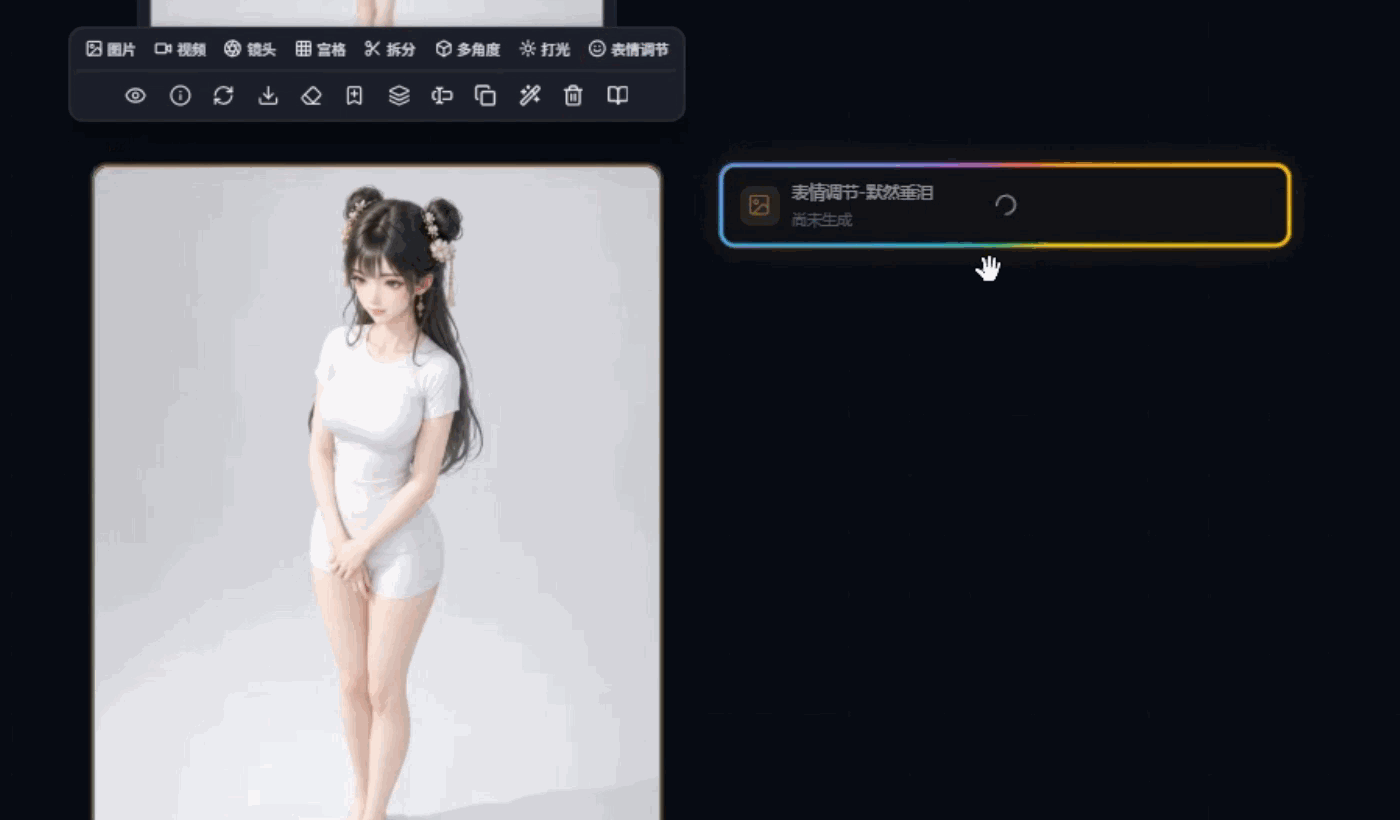
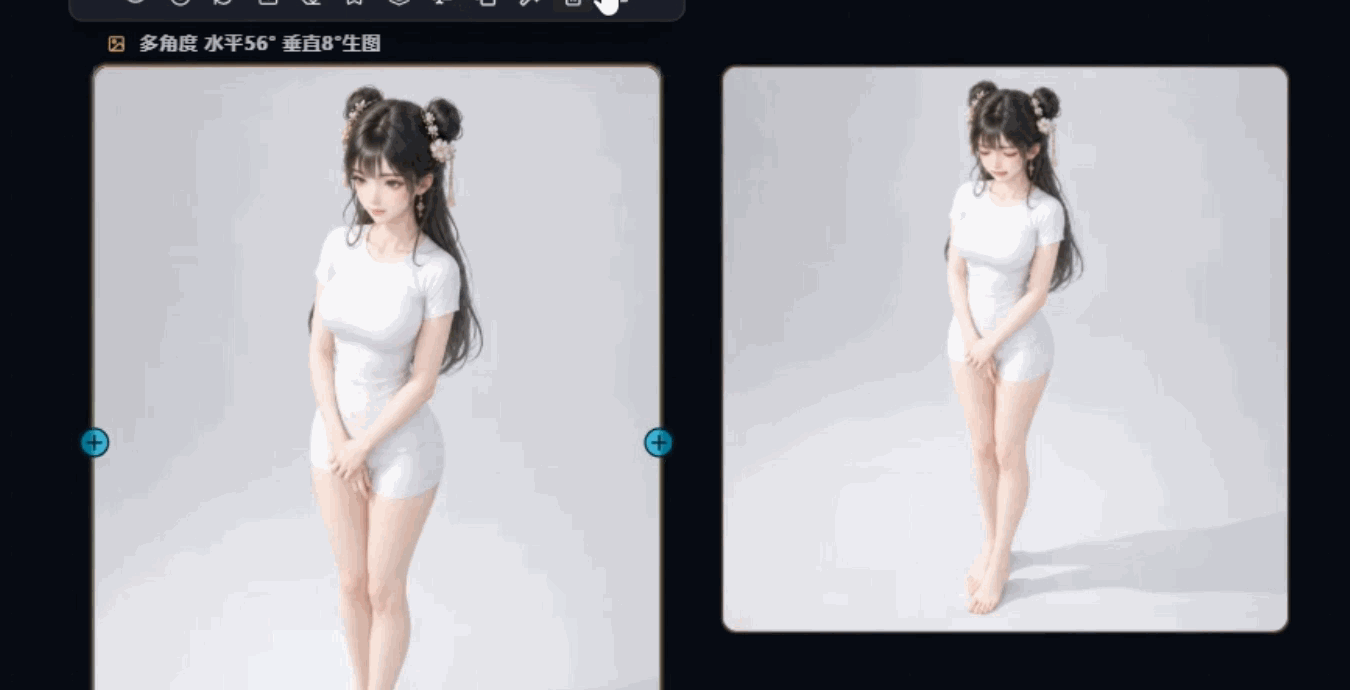
出图后,原图与调完表情的版本在画布上并排放着,点开新节点的图可以放大细看。不满意就回到原图节点重开面板、换一格再生成一次——原图始终不会被改掉,同一张图想试几种情绪就试几种。
下面这段视频完整演示了从打开【表情调节】、在点阵上挑情绪与强度,到点【生成】拿到成图的全过程。
视频演示:无限画布【表情调节】的入口、点阵选情绪与生成 —— 无法内嵌播放时点此直接打开视频
三、在 灵境 AI Model Hub(cloud-token.ai)上实践
灵境 AI Model Hub 是一个聚合 500+ 前沿大模型 的一站式 AI 平台,提供多模型对话、AI 写作与图像 / 视频 / 音乐生成,统一 OpenAI 兼容 API,支持免费试用。
- 看着素模挑情绪:左边灰白 3D 头像会实时换表情,比对着文字猜准得多;
- 要克制就往左收:强度最右端动作幅度最大,也最容易偏离原样貌,收一两格往往既保情绪又保长相;
- 同一张多试几格:结果各落在新节点、原图不动,一次试出一组情绪连贯的图很方便。
👉 立即免费体验 500+ 前沿大模型:灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link
四、常见疑问(FAQ)
Q:需要先把人脸框出来吗? A:不需要。面板打开就把整张源图当作【角色1】,直接选情绪、点生成即可。
Q:画面里有好几个人怎么办? A:生成指令里要求对画面中所有可见人脸做同样的表情调整,所以是整体一起变,不区分单独调某一个人。
Q:左边那张灰白的头像会不会被画进结果里? A:不会。它只是交给模型的表情参考示意,生成指令里明确要求只参考它的五官表情与情绪强度,不要复制它的外观、材质、光影或背景。
Q:生成结果会覆盖原图吗? A:不会。结果落在一个新节点上,原节点原样保留,可以反复拿同一张图试不同情绪。
Q:表情变了,但人也变得不太像了? A:换一格强度试试:强度拉到最右端时面部肌肉动作幅度最大,观感上最容易偏离原样貌。往左收一两格通常既有情绪又能保住长相;同一格重新生成一次也可能得到更稳的结果。
Q:想让一组图里每张情绪浓淡一致,怎么做? A:先在其中一张上试出满意的那格强度,记下点阵位置与【情绪定位】的名字(如「浅然莞尔」),其余几张都选同一格再生成,浓淡就统一了。原图不会被改,可以放心逐张试。
在 灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link 上,表情在 5×5 点阵上挑、强度随手调,只改脸不动人,一组图的情绪一次调齐。
画布与节点的基础操作可查阅 无限画布怎么用?;同一张图想换机位重拍可查阅 无限画布【多角度】怎么用?;视频里要消除或替换某个物体可查阅 无限画布【主体】怎么用?。
参考来源
常见问题
需要先把人脸框出来吗?
画面里有好几个人怎么办?
左边那张灰白的头像会不会被画进结果里?
生成结果会覆盖原图吗?
表情变了,但人也变得不太像了?
想让一组图里每张情绪浓淡一致,怎么做?
相关阅读
无限画布中音视频分离功能怎么用
视频音画绑在一起只想要一半时,用【音视频分离】一步拆开:在「无限画布 S2(Beta)」里把鼠标移到视频节点 → 工具条点【音视频分离】→ 菜单只有一项(没有「只要音频/只要视频」开关与格式选择,点了就是两个都要)→ 处理完成后原节点右侧新增两个节点:音频节点(如「音频输入_xxxx」,可看波形)与无声视频节点(如「视频输入_xxxx」,画面同原视频但无声音),两者都是普通输入节点可拖给别的节点当素材。原视频保留、画质音质不变、不消耗算力;无音轨的视频会先提示无法分离。智能体做出来的东西在哪找?怎么下载?
智能体的成果不只在当时的页面上:进入对应智能体首页点左上方【历史】下拉,即可看到名下所有任务(含名称、缩略图、创建时间与状态);点开任务回到工作台,上方分段标签页可切回「分析结论」「出图方案」等阶段产物,右侧对话流保留完整沟通记录。成品在产物展示区可悬停单张【下载】、【放大查看】或【重新生成】,右上角【全部下载】一键打包;工作台顶部时钟图标还能随时滑出历史任务抽屉切换项目。附不同智能体的产物形态差异与默认 30 天保留提醒。智能多帧怎么用?一次出一组连贯画面
要做一条连贯长片不必自己逐段生成再拼接:左侧【智能体】→【智能多帧】,上传多张参考图(上限以界面提示为准,支持本地/资产库/扫码)并填写创意描述,底部选目标时长(15/30/60 秒)、分辨率与生成策略,可选【逐步确认】逐节点把控或【智能托管】全自动推进。提示词用「锁定不变 + 细化变化」写法:全局固定角色外观、服装、艺术风格、主色调与光影,分镜只写运镜与动作演变。系统会自动生成各段高清首尾帧做衔接,分段生成后自动拼成完整长视频,点【下载视频】导出;单段不满意可单独重跑。附消耗与 30 天存储提醒。智能体跑到中间某一步不满意?能不能只改这一步重跑
智能体某一步不满意不必推倒重来,有四种就地改法:①流程型智能体保持【逐步确认】,点当前步骤的【重新生成】只重推这一步,或用【给下一步的补充提示词】追加要求,也可用【回退】退回上一步;②在【分析结论】面板点【编辑】直接手改人群、卖点等中间结论,或在对话框发指令;③方案工作台里逐字改【生图提示词】,再【生成这一张】只出这一张;④长视频/多镜头任务按分段,点【重新生成提示词】或【重新生成视频】单独重做某段。附起始页写清约束、批量确认不可回退等四条省时建议。相关平台
关于大模型的选型、调用与落地实践,你还可以访问以下平台:
- cloud-lab.cn —— 灵境AI 模型百科:大模型选型、对比评测与用户手册,AI Model Hub 官方知识站。
- cloud-token.ai(AI Model Hub 国内版) —— 聚合 500+ 前沿大模型,统一 OpenAI 兼容 API,免费试用、按量计费。
- cloud-ai.link(AI Model Hub 国际版) —— 面向全球用户,英文界面,统一 OpenAI 兼容 API,即开即用。