几段视频能不能在站内拼成一条?无限画布【合成】节点和长视频智能体怎么用
几段视频能不能在站内拼成一条?无限画布【合成】节点和长视频智能体怎么用 关键参数
| 方式一·合成节点 | 【智能体】→【无限画布】→【新画布】→ 添加【合成】节点 → 本地文件用【视频输入】节点上传、画布片段用【视频生成】输出 → 连到合成节点输入端(两段以上自动显示「多视频 · 拼接合并」)→ 选【输出尺寸】(保持原尺寸或统一到 1920×1080)→ 运行后预览/下载/批量下载 |
|---|---|
| 合成节点细节 | 合并顺序按连线先后;加【音频输入】节点可变成「多视频 + 音频 · 合并并替换音轨」,单视频加音频则为「视频 + 音频 · 替换音轨」;节点输入框可用 @ 引用画布素材 |
| 方式二/三 | 【智能多帧】类长视频智能体:梳理大纲 → 规划分段 → 逐段生成 → 自动合成 → 整片下载;需要转场/字幕/卡点时则用方式三:分段生成 → 播放确认 → 下载(可「下载所有成功的视频」批量打包)→ 本地剪辑软件精修导出 |
| 拼得自然 | 上一段尾帧截图作下一段【首帧】(需支持首尾帧控制的模型);各段固定主体外观、光影色调与镜头风格词;单段时长取适中短镜头档位 |
几段视频能不能在站内拼成一条?无限画布【合成】节点和长视频智能体怎么用
单个视频模型一次只能出一段,想要一条完整成片就得把多段接起来。站内其实可以完成拼接,不必先把素材倒进剪辑软件。本文给出三条路径:无限画布的【合成】节点(最直接)、长视频智能体(一站式出整片)、下载到本地精修(需要转场字幕时),并说明让多段画面拼得自然的分段技巧。
一、方式一:用【无限画布】的【合成】节点把多段视频接成一条
这是站内最直接的拼接方式,既能拼你自己上传的视频,也能拼画布里刚生成出来的片段。
- 进入【智能体】专区,在左侧列表中打开【无限画布】,点击【新画布】新建一块画布。
- 在画布空白处右键(或使用添加节点入口),添加【合成】节点。
- 准备好要拼的素材:需要拼本地文件时,添加【视频输入】节点并把视频上传进去;想拼画布里生成的片段时,直接用【视频生成】节点的输出。
- 把这些素材节点逐个连到【合成】节点的输入端。连入两段以上视频后,节点顶部的模式会自动显示为「多视频 · 拼接合并」。
- 在节点里选择【输出尺寸】:可以【保持原尺寸】,也可以统一到某个固定分辨率(如 1920×1080)。各段素材尺寸不一致时,建议指定一个统一分辨率,避免成片画面跳变。
- 点击节点上的运行按钮。合成完成后节点下方会出现结果,点开可预览,也可以直接下载;结果为多条时还能用【批量下载】一次打包。
几个实用细节:
- 合并顺序按连线输入的先后顺序来,提交前建议先确认各段的连接顺序是否就是你想要的叙事顺序。
- 想换掉整条视频的声音:在【合成】节点上再连一个【音频输入】节点,模式会变成「多视频 + 音频 · 合并并替换音轨」,拼接的同时把音轨替换成你提供的音频。只连一段视频加一段音频时,则是「视频 + 音频 · 替换音轨」。
- 节点自带的输入框可以填写合成提示词,并用 @ 引用画布里的视频或音频素材。
二、方式二:用长视频类智能体,分段生成后自动出整片
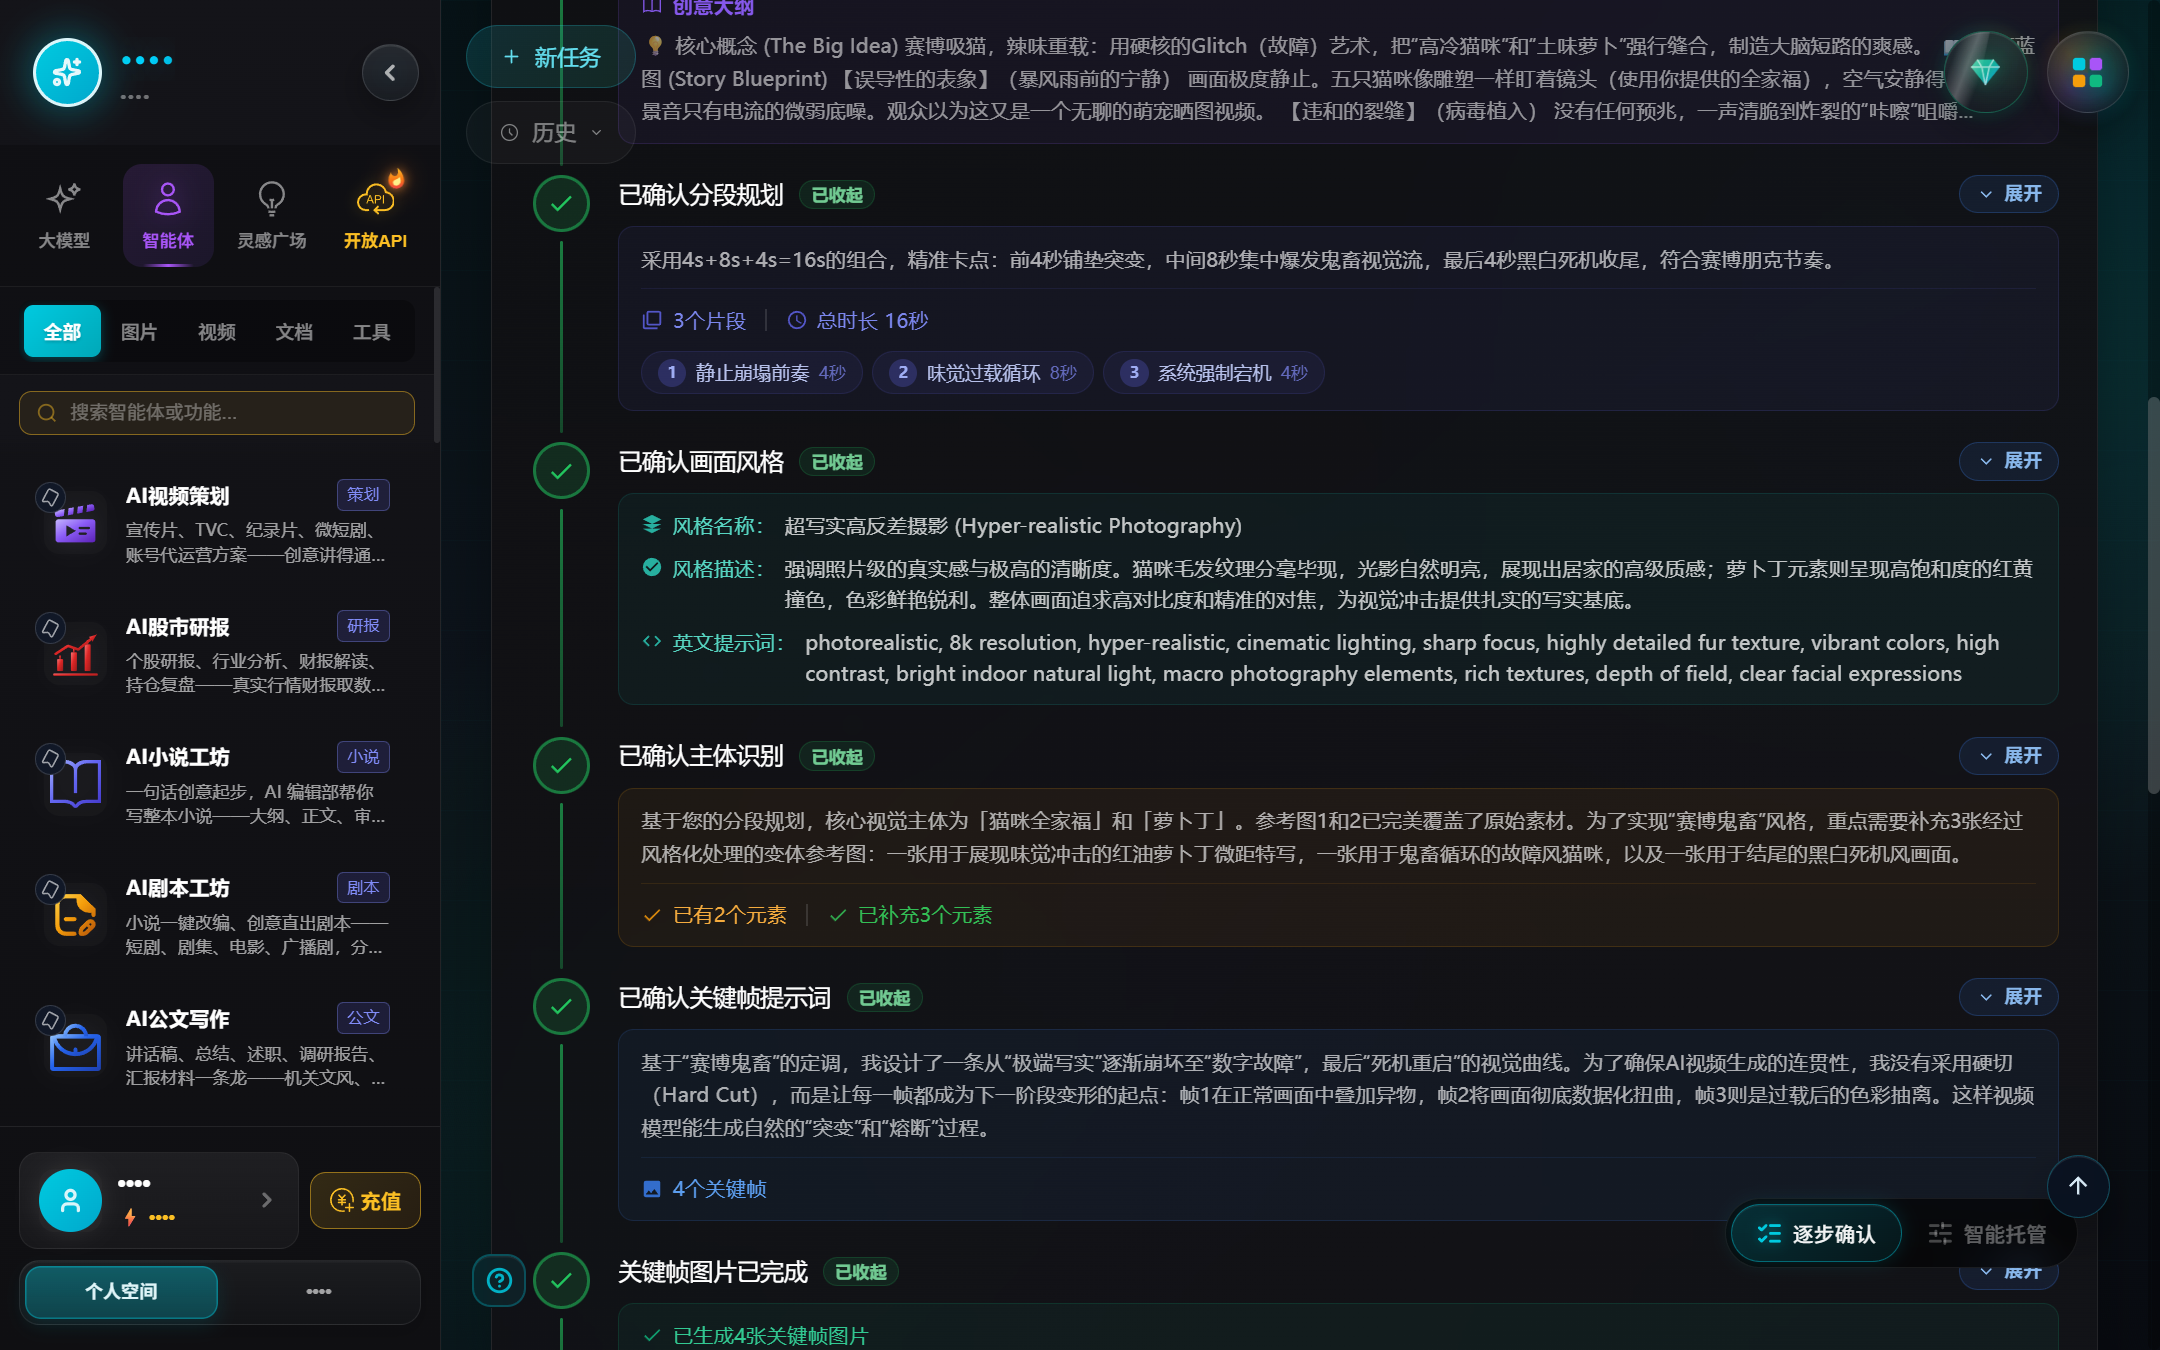
如果你希望在站内一站式完成从构思到整片输出的全流程,可以前往【智能体】专区,选用【智能多帧】这类专门用于长镜头或多镜头叙事的视频智能体。
这类智能体会按照分步流程协助你梳理创意大纲、规划镜头分段,并逐段生成画面提示词与视频片段。当全部片段生成完毕后,系统会自动执行视频合成,并在最后一步提供整片下载。
三、方式三:分段生成后下载,用本地剪辑软件精修
如果你需要逐帧调整转场、叠字幕、卡音乐点这类精细操作,站内的合成节点只做顺序拼接,这种情况仍建议把片段下载下来交给专业剪辑软件收尾:
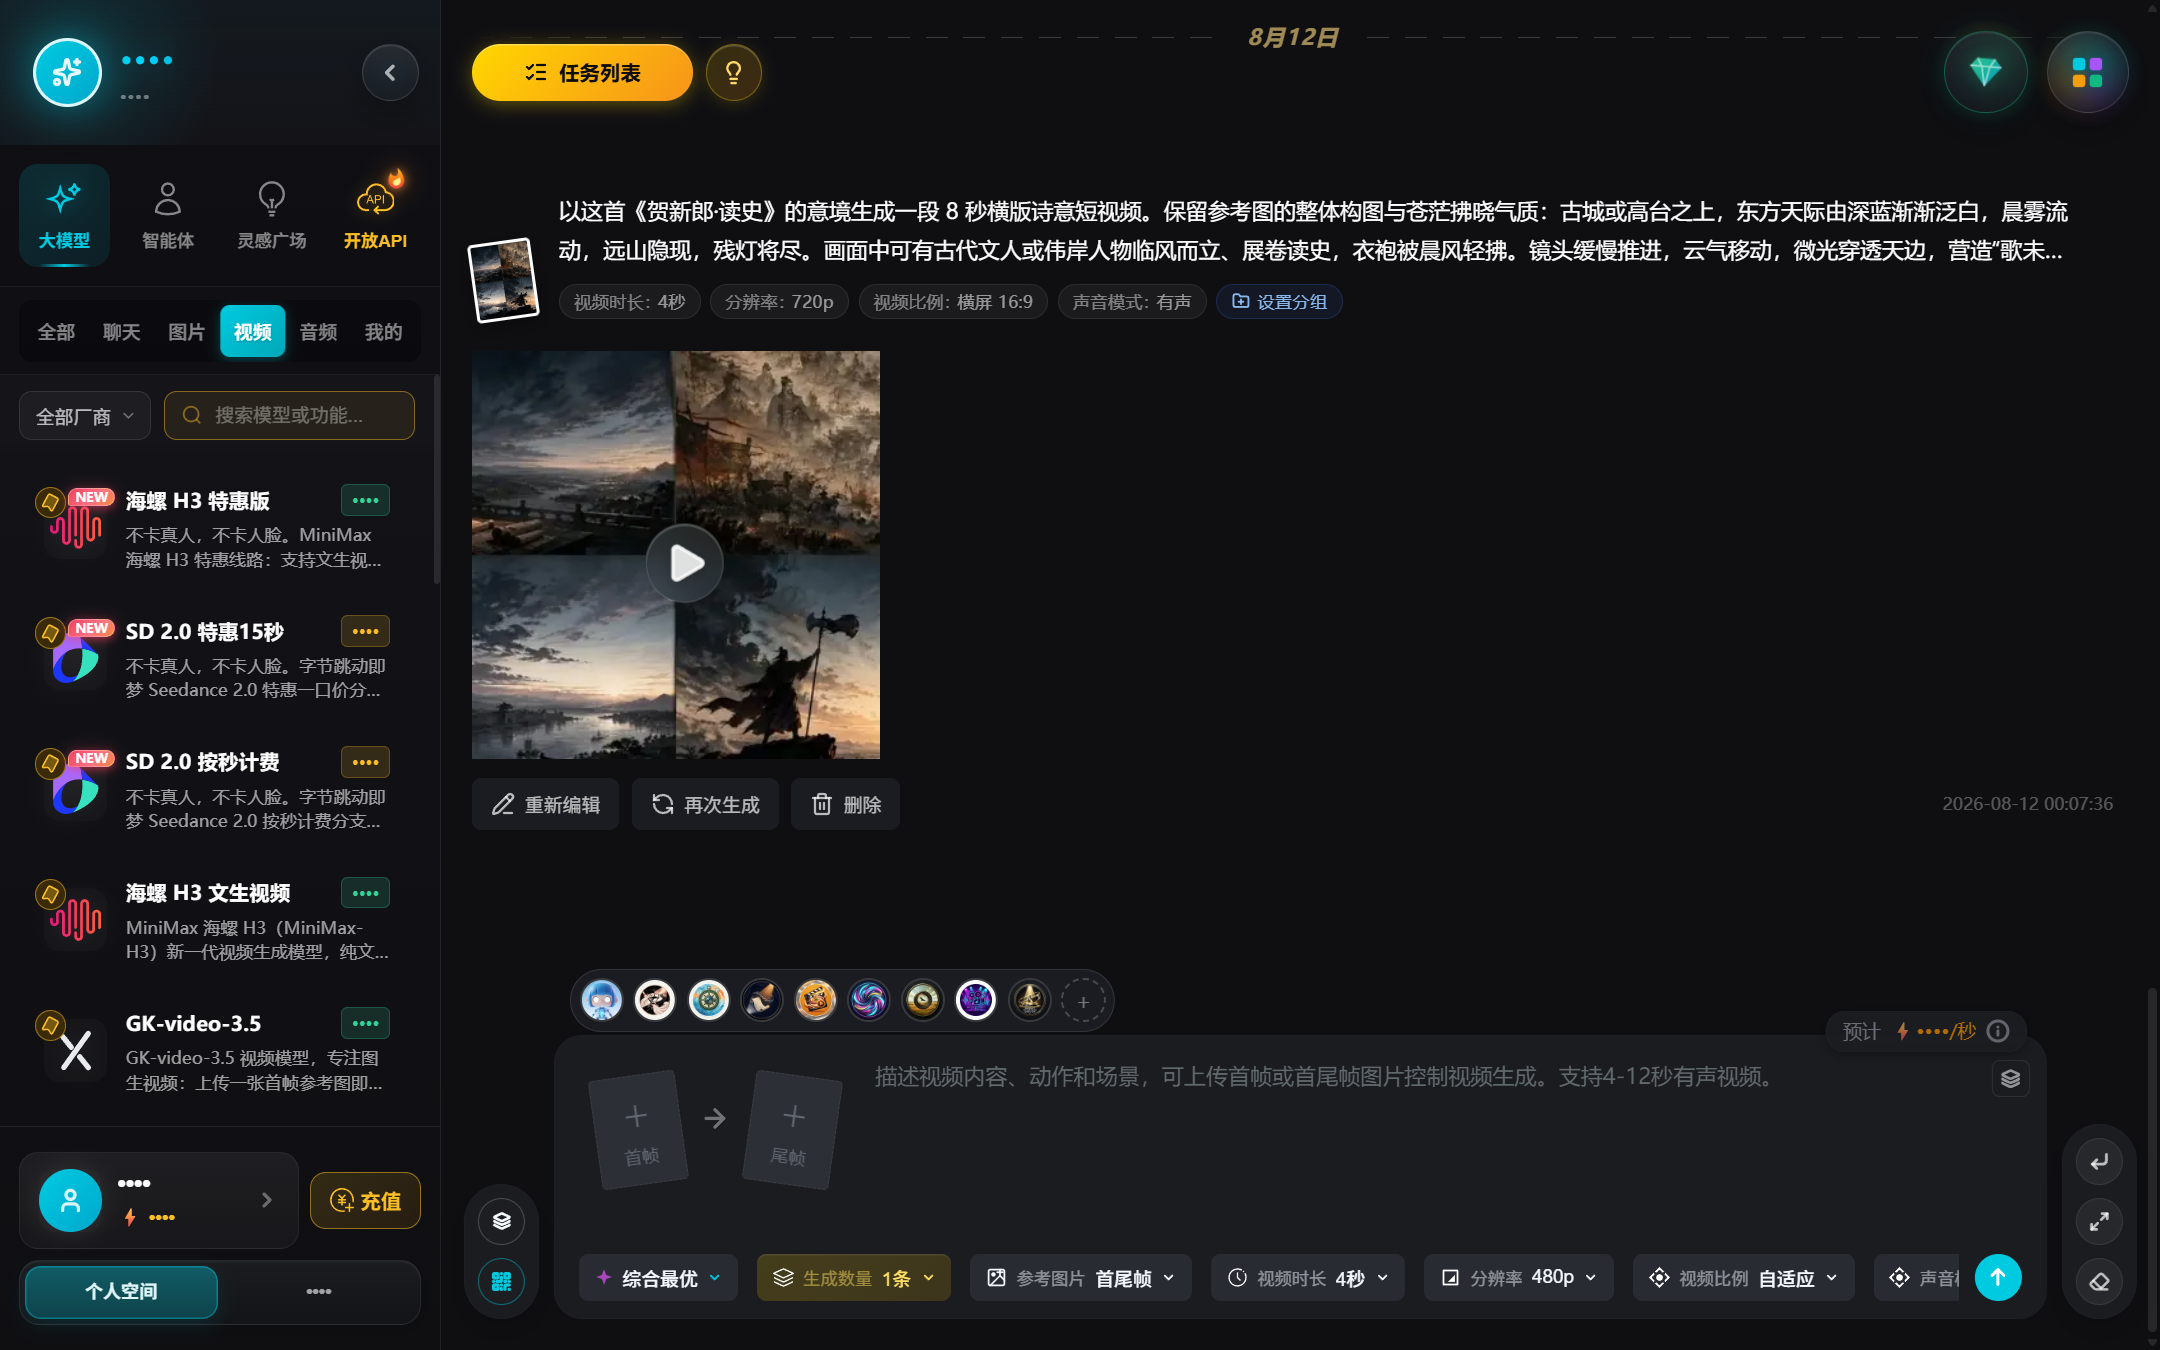
- 在【视频】专区选择适合的模型,根据分镜脚本逐段输入描述并提交生成。
- 生成完成后,在任务卡片上点击播放预览;确认画面满意后,点击下载按钮将各段视频文件保存到本地电脑。需要一次性拿走多条时,可以点击悬停提示为「下载所有成功的视频」的那个图标,在弹出的下载弹窗里选择【批量下载】打包保存。
- 将下载好的多段视频素材导入常见的视频剪辑软件中,进行自由排序、裁剪过渡、添加背景音乐与字幕,最终导出完整成片。
单条与批量的更多下载方式可查阅 生成好的视频怎么下载和分享?。
四、想让多段画面拼得自然的实用建议
无论用站内合成还是本地剪辑,前后镜头衔接是否自然,主要取决于分段生成时的处理方式。可以参考以下操作要点:
1. 巧妙利用上一段的尾帧作为下一段的首帧
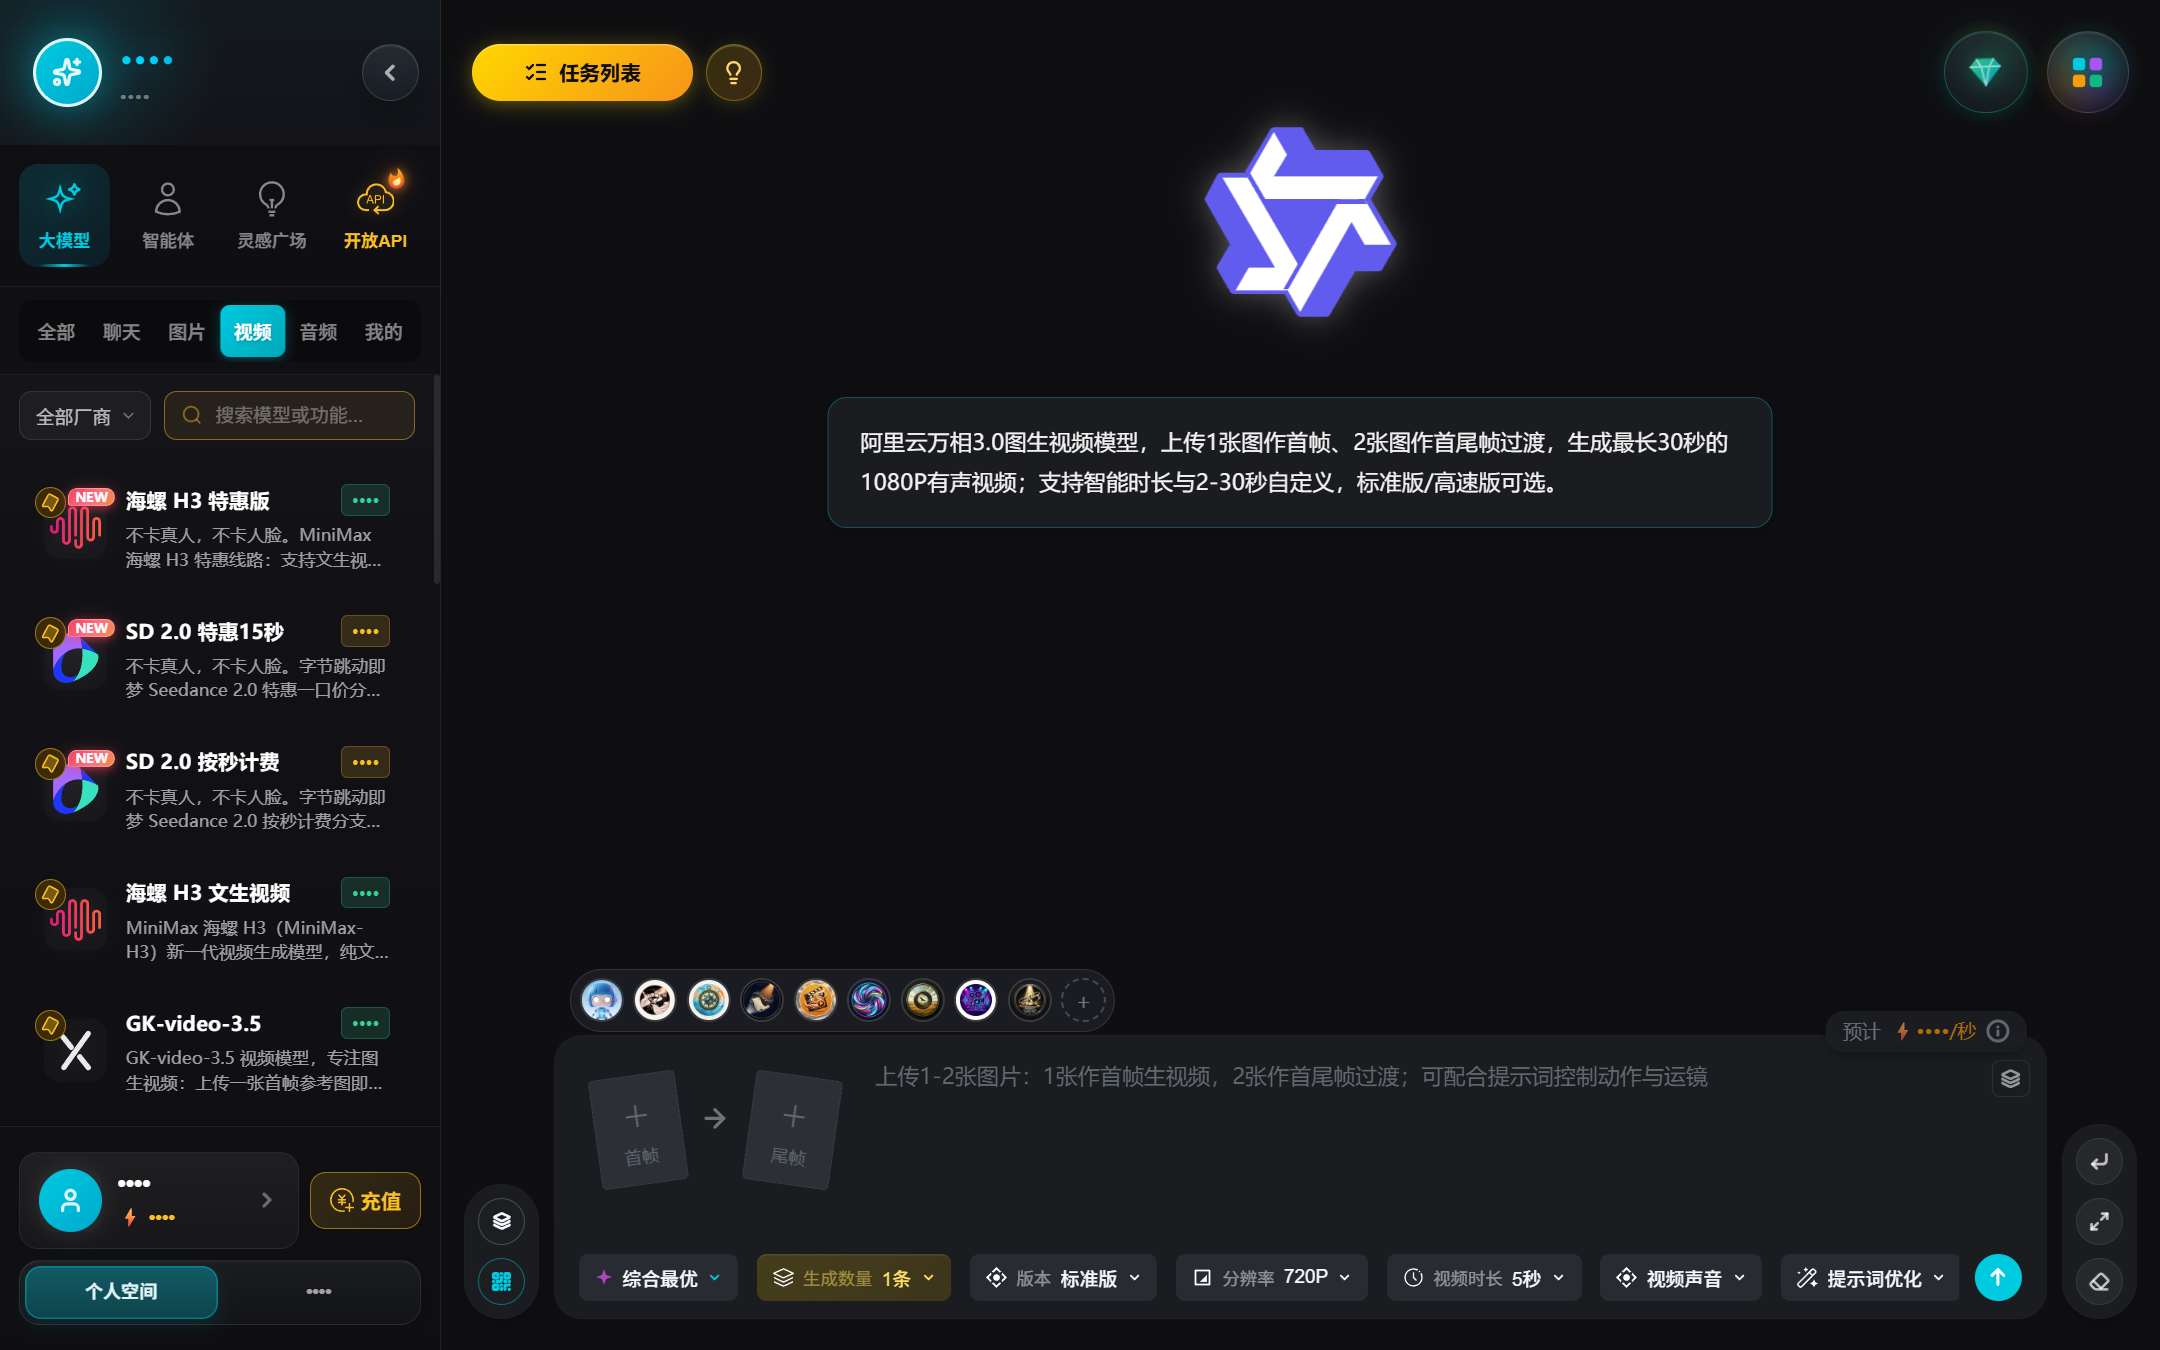
在【视频】专区选择支持首尾帧控制的模型时,界面会提供【首帧】与【尾帧】两个上传槽位。
- 将前一段视频的最后一帧画面截取或保存为图片;
- 在制作下一段视频时,将该图片上传至【首帧】槽位,配合新的动作描述进行生成;
- 这样能让新镜头的起始构图与上一镜头平滑相接,通常可以减少镜头切换时主体与背景出现突兀跳变的情况。
2. 保持画面风格与关键描述词一致
在编写每一段视频的提示词时,建议把核心主体的外观特征(如发型、服装、材质)、场景环境(如光影方向、色调基调)以及镜头风格词固定下来。统一的视觉基调能让分段拼接后的成片保持连贯的统一感。
3. 单段时长不宜过长
建议将每个片段的时长控制在适中的短镜头范围(具体时长以所选模型界面提供的档位为准)。短镜头通常能让模型的动作遵循更精准,后期无论在画布里合并还是在剪辑软件中调整叙事节奏,都更为灵活。
五、在 灵境 AI Model Hub(cloud-token.ai)上实践
灵境 AI Model Hub 是一个聚合 500+ 前沿大模型 的一站式 AI 平台,提供多模型对话、AI 写作与图像 / 视频 / 音乐生成,统一 OpenAI 兼容 API,支持免费试用。
- 短镜头分段:一个镜头一段,动作更精准,拼起来节奏也更灵活;
- 尾帧接首帧:上一段最后一帧存成图,下一段放进【首帧】槽,衔接处的跳变明显减少;
- 统一基调:各段的主体外观、光影色调与镜头风格词固定一套,成片才有整体感。
👉 立即免费体验 500+ 前沿大模型:灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link
六、常见疑问(FAQ)
Q:站内的【合成】节点能不能做转场特效、加字幕? A:合成节点主要负责把多段视频按顺序接成一条,并可统一输出尺寸、替换整条音轨。如果需要交叉溶解、花字、逐段调速这类精细剪辑,建议按方式三下载素材后在本地剪辑软件里完成。
Q:分段生成多个视频时,消耗怎么核对? A:每一个视频任务提交后均会独立计量,画布里的合成任务同样会单独记录。如果需要核对各片段的扣费明细与任务状态,可在个人中心打开【消费记录】,按提交时间逐笔查看。
Q:为什么不建议单次直接生成很长的单镜头? A:单镜头时长越长,画面中人物或物体的动作越容易出现变形或逻辑漂移。采用多镜头分段叙事、再通过站内合成或剪辑软件组装,是目前制作高质量视频作品更稳妥的做法。
Q:生成的视频素材在站内会一直保存吗? A:作品在站内有保留期限(具体以【我的作品】页顶部的保留提示为准)。建议生成满意的视频片段后及时下载到本地保存,以免影响后续拼接与剪辑使用。
Q:【合成】节点和「视频 + 音频 · 替换音轨」有什么区别? A:只连一段视频加一段音频时,是「视频 + 音频 · 替换音轨」,给这条视频换个声音;连两段以上视频再加音频时,模式变成「多视频 + 音频 · 合并并替换音轨」,一边拼接一边把整条音轨换掉。
在 灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link 上,多段视频可在画布里直接拼成一条,也能下载到本地精修,长片分段做更稳。
参考来源
常见问题
站内的【合成】节点能不能做转场特效、加字幕?
分段生成多个视频时,消耗怎么核对?
为什么不建议单次直接生成很长的单镜头?
生成的视频素材在站内会一直保存吗?
【合成】节点和「视频 + 音频 · 替换音轨」有什么区别?
相关阅读
配音音色怎么挑?语速情绪能调吗
音色库按通用、视频配音、角色扮演、多语种、客服、教育、有声阅读等场景分类,顶部可按男声/女声切换,每张卡片都能【试听】再决定:知识讲解选清晰沉稳男声或知性音色,故事旁白选温和有起伏女声,短视频选活泼卡通音色,出海内容选多语种音色。语速支持 0.5x~2.0x(带货短视频可 1.25x,朗读教学建议 1.0x),情感可选开心/悲伤/平静等并调强度,输出支持 MP3。建议先用 10~20 字短句试音再整篇合成。AI 配音读错字、断句奇怪、该停的地方不停?怎么把停顿和读音调顺
配音念得别扭先改文本:补逗号句号分号破折号来制造停顿(补齐标点音频会变长,多出来的是停顿)、长复句拆成短句、要久停就换行;多音字换同义词、专有名词写成口语、英文缩写按读法写。再调参数:语速降一档改善「黏成一片」,情感/语调按需选。支持自然语言指令的模型可把「怎么说」写在文本开头「讲戏」。另附音色挑选与一次只改一处做对比的方法。生成过的配音和音乐在哪找回来?下载、保存,以及拿到画布里继续用
音频找不到多半是切了模型:对话区与【任务列表】都只看当前模型,切回去就在;不分模型一起看去个人中心【我的作品】→【音频】(可按日期收窄、批量下载/导出链接)。卡片上可【下载音频】【复制下载链接】【加入资产库】,入库后在【合成】节点的【音频】位用【从资产库选择】挑回画布继续用(【音频输入】节点无此入口)。注意作品保留 1~15 天、附件类资产 30 天,长期素材下载到本地最稳。一段录音或视频怎么转成文字?会议记录、访谈整理、做字幕
站内没有独立转写专区,录音或视频转文字在【聊天】页面做:选支持多模态的模型 → 点【上传】传入音视频文件 → 说明要逐字稿、会议纪要还是字幕格式。附三个可直接复制的提示词模板(逐字转写标 [听不清] / 会议纪要与待办提炼 / 字幕短句切分),以及人工核对要点、时间戳为估测值的说明与隐私合规提醒。相关平台
关于大模型的选型、调用与落地实践,你还可以访问以下平台:
- cloud-lab.cn —— 灵境AI 模型百科:大模型选型、对比评测与用户手册,AI Model Hub 官方知识站。
- cloud-token.ai(AI Model Hub 国内版) —— 聚合 500+ 前沿大模型,统一 OpenAI 兼容 API,免费试用、按量计费。
- cloud-ai.link(AI Model Hub 国际版) —— 面向全球用户,英文界面,统一 OpenAI 兼容 API,即开即用。