生成的图里文字是乱码、写错字,怎么办?
生成的图里文字是乱码、写错字,怎么办? 关键参数
| 出错根因 | 模型把汉字当作线条与像素纹理绘制,而非调用字体库矢量排版;笔画多、字数长、排版复杂即易粘连乱码 |
|---|---|
| 字数与标注 | 单次文字控制在 2~4 个汉字(如"欢迎光临"),并用双引号括出以明确文字边界 |
| 位置朝向字体 | 写明载体(招牌/黑板/灯箱/书本封面/包装袋)、优先横排(竖排易顺序颠倒叠字)、字体风格(楷体/黑体/印刷体/手写体) |
| 三条补救路径 | ①【再次生成】或切换模型 ②【编辑图片】圈选错字区域局部重绘 ③提示词要求"纯净留白、无文字"生成后手动加字 |
生成的图里文字是乱码、写错字,怎么办?
AI 图像模型在生成带文字的图片时,常会出现乱码、错别字、笔画粘连和文字顺序异常等问题。这些问题通常与文字数量、笔画复杂度及排版方式有关。通过精简文字、明确位置与字体风格,并在生成出错后进行局部重绘或后期加字,可以明显改善结果。
一、为什么生成的图里容易出现错别字或乱码?
目前主流图像生成模型在处理文字时,底层逻辑是将汉字和字母作为画面中的“线条与像素纹理”一起绘制,而非调用字体库进行矢量排版。当文字笔画较多、字数较长或排版复杂时,模型容易出现笔画粘连、形似错字或无意义乱码。
这事儿其实有规律,在提示词和操作上注意以下几点,文字出错的概率通常会低一些。
二、提高文字正确率的实用技巧
1. 文字尽量简短,用双引号明确标注
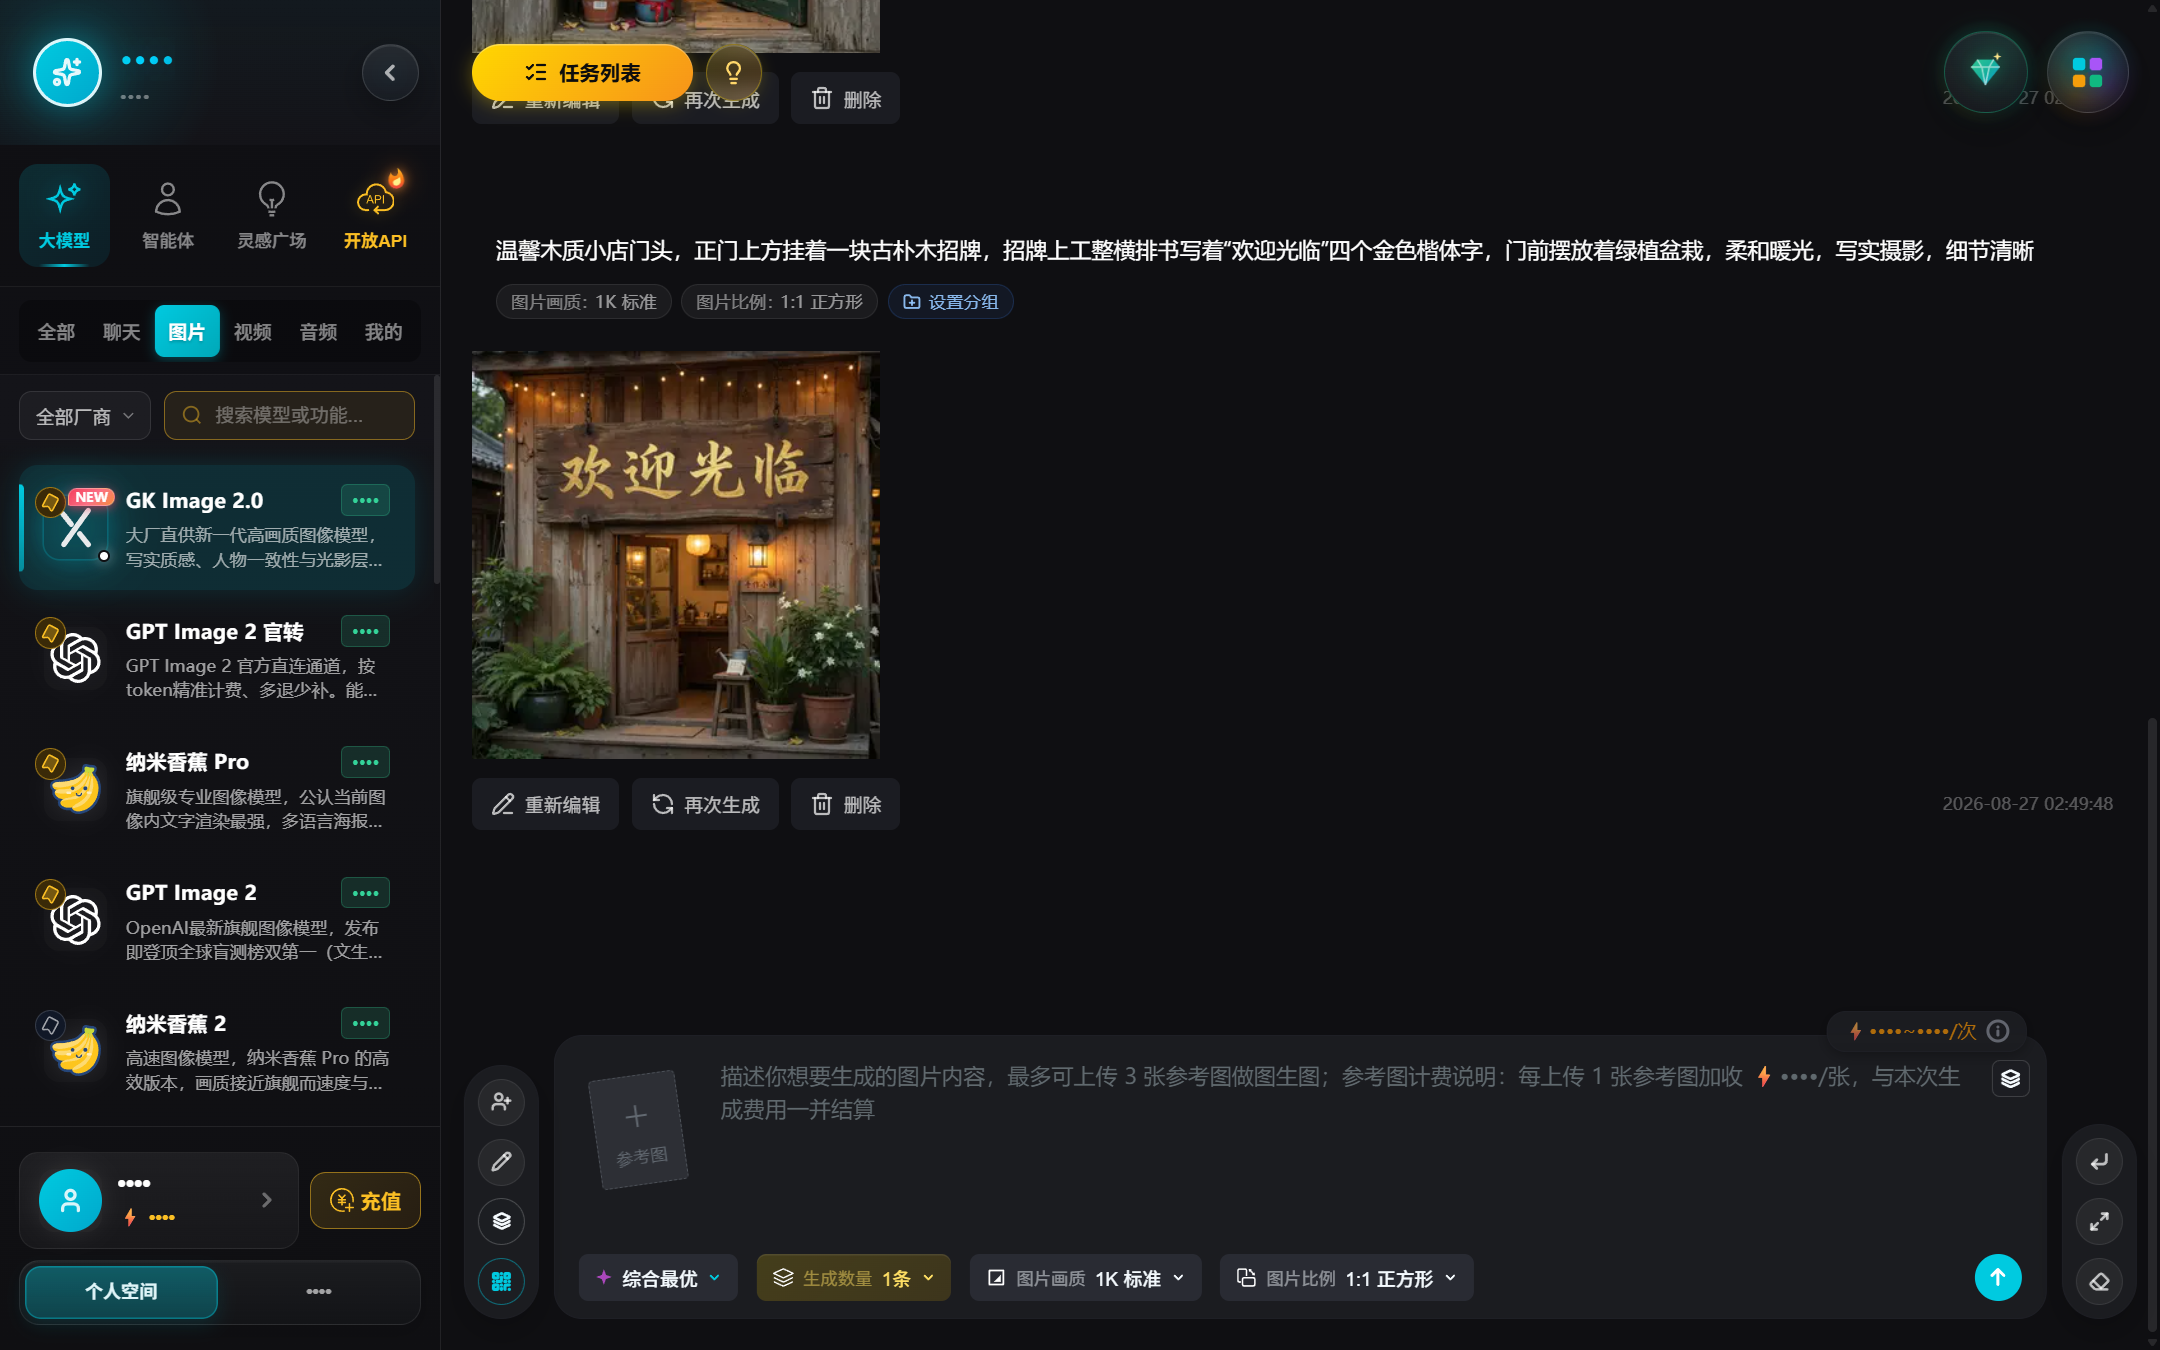
尽量避免在画面中塞入整句长句或生僻字,单次文字建议控制在 2~4 个汉字(如“欢迎光临”“开业大吉”)。在输入提示词时,将需要展示的文字用双引号明确括起来,让模型清晰识别文字边界。
2. 明确文字位置、朝向与字体风格
提示词中明确写清文字出现的具体载体、排列朝向与风格特征。例如:正门上方古朴木招牌上,横排工整书写着“欢迎光临”四个金色楷体字。
- 排版朝向:优先使用横排排版,竖排文字极易发生顺序颠倒与叠字;
- 载体明确:写明文字依附的载体(招牌、黑板、灯箱、书本封面、包装袋等);
- 字形风格:描述具体的书法或字体风格(如楷体、黑体、印刷体、手写体)。
三、出错后的 3 种补救路径
路径一:微调提示词或切换模型再次生成
如果生成的文字个别笔画有偏差,可点击卡片下方的【再次生成】;部分模型对文字渲染与排版支持较好(以实际生成结果为准),也可以切换不同模型多做尝试。
路径二:使用【编辑图片】局部涂抹精修
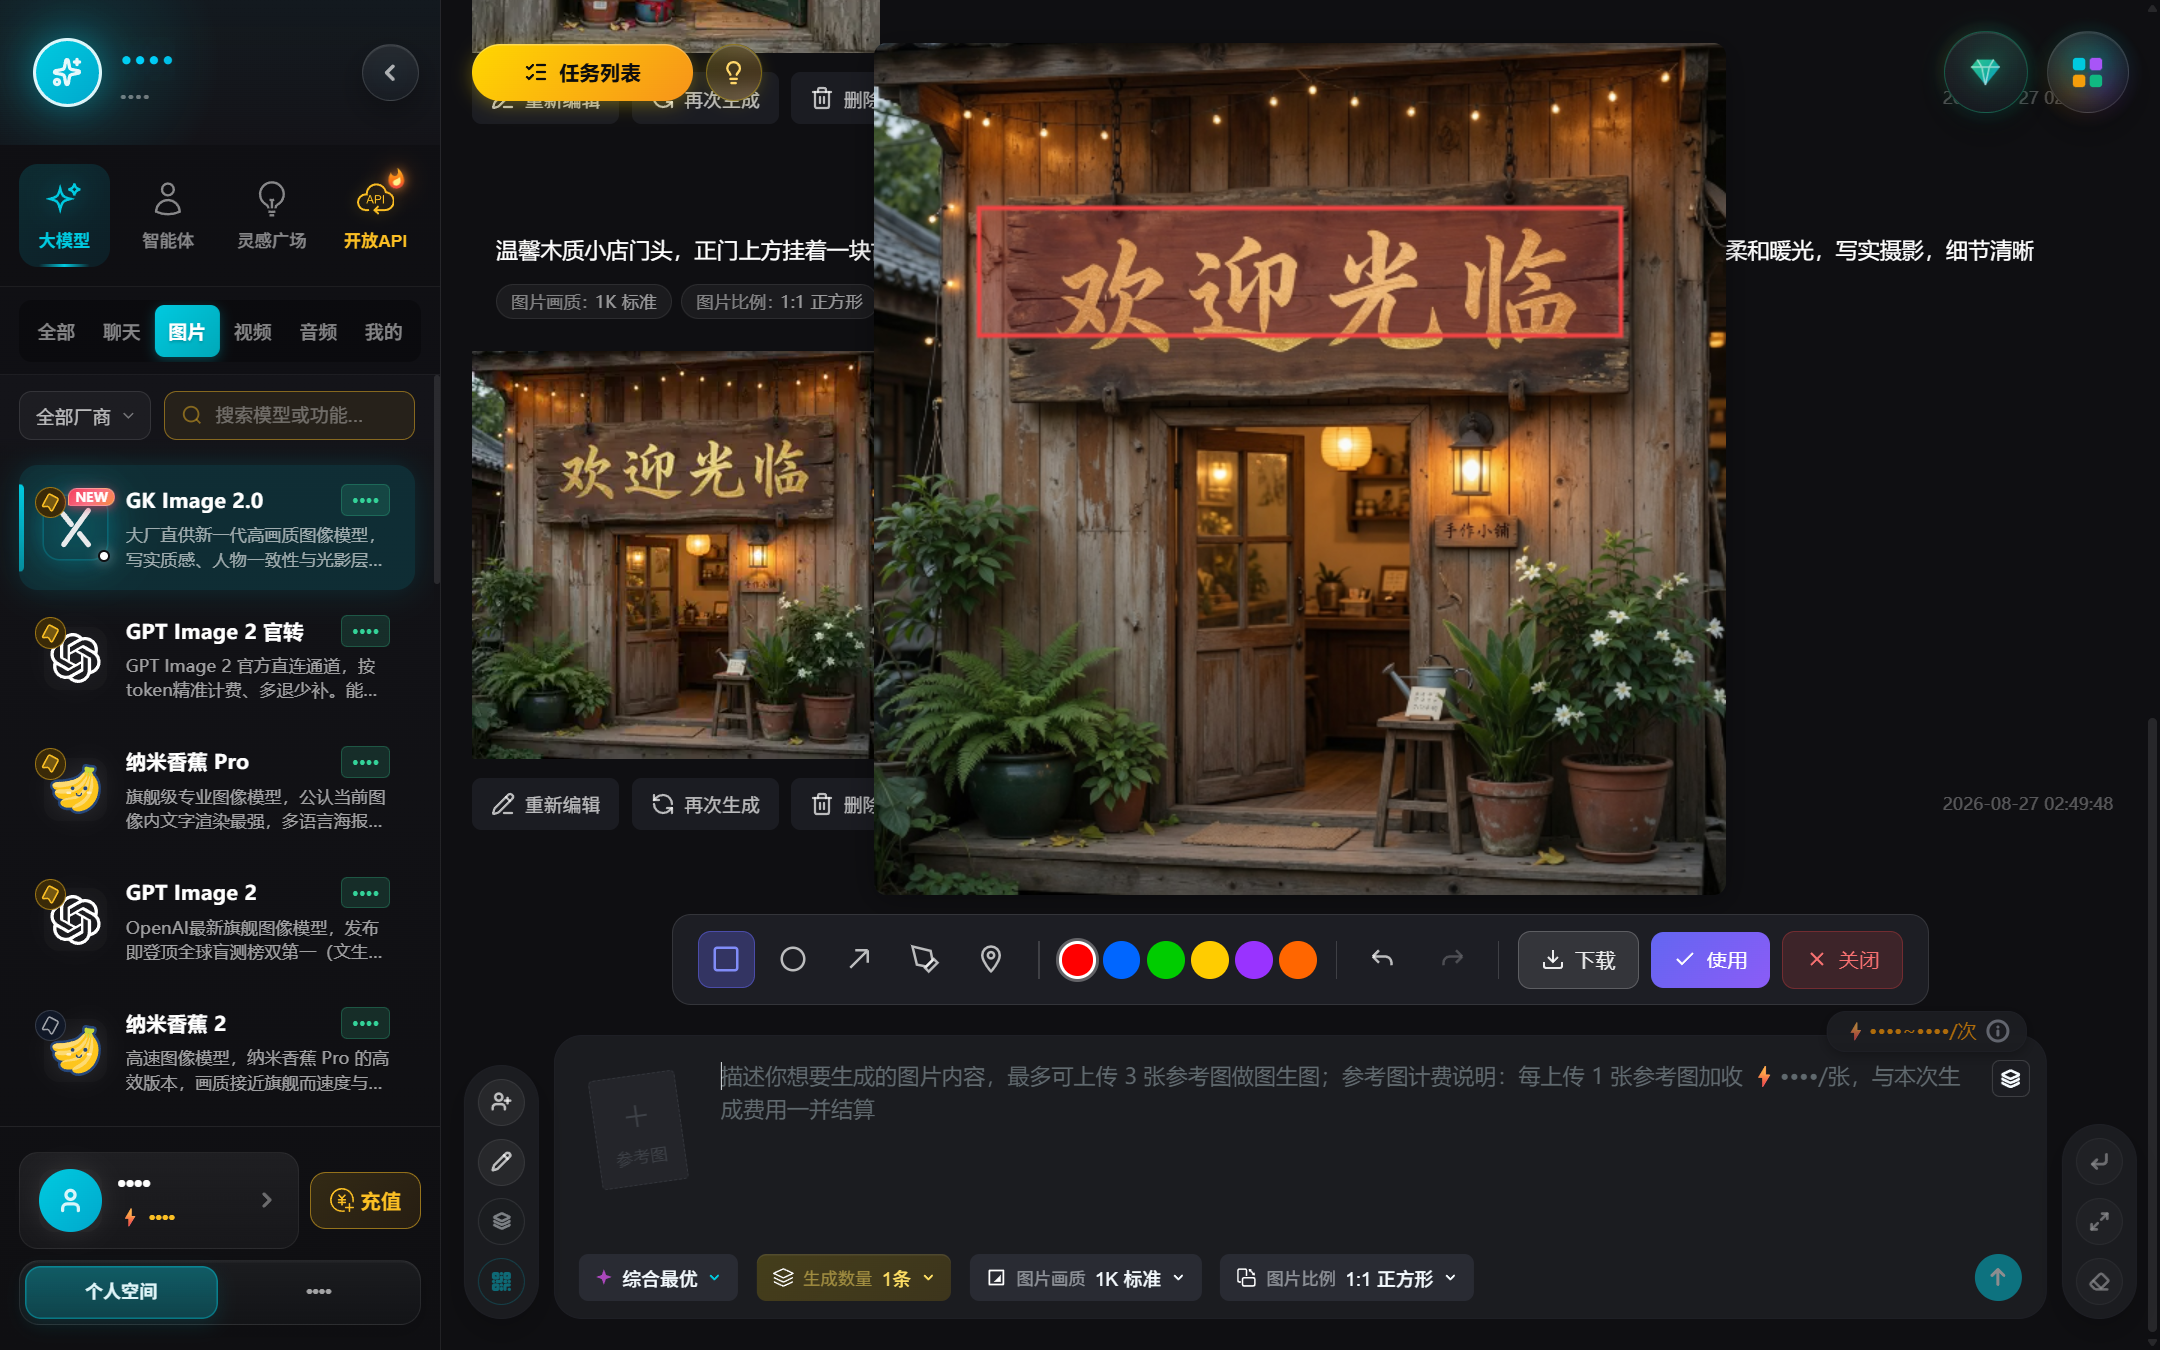
点击图片打开大图预览,选择【编辑图片】,使用画笔或矩形框选出错的文字区域,在输入框中单独描述该区域要修改的文字内容进行局部重绘,无需重新生成整张画面。
路径三:提示词要求“纯净留白”,后期手动加字
对于商业海报、产品包装或印刷级物料,一种实用的做法是在提示词中明确要求“招牌上保持干净纯色、无文字、留出排版空白”,生成无字的纯净背景图后,使用常用修图或排版软件自行添加标准矢量文字。
四、在 灵境 AI Model Hub(cloud-token.ai)上实践
灵境 AI Model Hub 是一个聚合 500+ 前沿大模型 的一站式 AI 平台,提供多模型对话、AI 写作与图像 / 视频 / 音乐生成,统一 OpenAI 兼容 API,支持免费试用。
- 先控字数:单张图上的文字尽量 2~4 个字,越少越不容易错;
- 再定规格:写清载体、横排朝向与字体风格,让模型知道字该长什么样;
- 出错别急着重画:先【再次生成】,不满意再走【编辑图片】局部重绘,商用物料直接留白后期加字最稳。
👉 立即免费体验 500+ 前沿大模型:灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link
五、常见疑问(FAQ)
Q:怎么判断生成的文字能不能直接用于商业印刷? A:重要用途(如印刷品、门头招牌、对外宣传海报)建议在最终使用前务必人工逐字核对笔画字形,不要直接上线。
Q:为什么英文比中文更容易生成正确? A:英文字母由基础拉丁字母组成、结构相对简单,而汉字结构与笔画组合更为复杂;按照简短横排的原则,中文短词同样可以取得不错的效果。
Q:出错后该重新生成,还是局部重绘? A:个别笔画偏差优先点【再次生成】或切换模型尝试;若整体构图已满意、只有个别字错,用【编辑图片】圈选文字区域做局部重绘;商业物料要求字形绝对准确,则走「纯净留白 + 后期手动加字」的路径。
Q:提示词里写“文字要准确、不能有错别字”有用吗? A:作用有限。模型是按纹理“画”字而不是按字体库排版,声明式约束并不能替代具体的写法;真正有效的是控制字数(2~4 字)、用双引号括出文字、写明载体与横排朝向与字体风格。
在 灵境 AI Model Hub | cloud-token.ai 或 cloud-ai.link 上,让 AI 出图带字不再靠运气。
参考来源
常见问题
怎么判断生成的文字能不能直接用于商业印刷?
为什么英文比中文更容易生成正确?
出错后该重新生成,还是局部重绘?
提示词里写"文字要准确、不能有错别字"有用吗?
相关阅读
配音音色怎么挑?语速情绪能调吗
音色库按通用、视频配音、角色扮演、多语种、客服、教育、有声阅读等场景分类,顶部可按男声/女声切换,每张卡片都能【试听】再决定:知识讲解选清晰沉稳男声或知性音色,故事旁白选温和有起伏女声,短视频选活泼卡通音色,出海内容选多语种音色。语速支持 0.5x~2.0x(带货短视频可 1.25x,朗读教学建议 1.0x),情感可选开心/悲伤/平静等并调强度,输出支持 MP3。建议先用 10~20 字短句试音再整篇合成。AI 配音读错字、断句奇怪、该停的地方不停?怎么把停顿和读音调顺
配音念得别扭先改文本:补逗号句号分号破折号来制造停顿(补齐标点音频会变长,多出来的是停顿)、长复句拆成短句、要久停就换行;多音字换同义词、专有名词写成口语、英文缩写按读法写。再调参数:语速降一档改善「黏成一片」,情感/语调按需选。支持自然语言指令的模型可把「怎么说」写在文本开头「讲戏」。另附音色挑选与一次只改一处做对比的方法。生成过的配音和音乐在哪找回来?下载、保存,以及拿到画布里继续用
音频找不到多半是切了模型:对话区与【任务列表】都只看当前模型,切回去就在;不分模型一起看去个人中心【我的作品】→【音频】(可按日期收窄、批量下载/导出链接)。卡片上可【下载音频】【复制下载链接】【加入资产库】,入库后在【合成】节点的【音频】位用【从资产库选择】挑回画布继续用(【音频输入】节点无此入口)。注意作品保留 1~15 天、附件类资产 30 天,长期素材下载到本地最稳。一段录音或视频怎么转成文字?会议记录、访谈整理、做字幕
站内没有独立转写专区,录音或视频转文字在【聊天】页面做:选支持多模态的模型 → 点【上传】传入音视频文件 → 说明要逐字稿、会议纪要还是字幕格式。附三个可直接复制的提示词模板(逐字转写标 [听不清] / 会议纪要与待办提炼 / 字幕短句切分),以及人工核对要点、时间戳为估测值的说明与隐私合规提醒。相关平台
关于大模型的选型、调用与落地实践,你还可以访问以下平台:
- cloud-lab.cn —— 灵境AI 模型百科:大模型选型、对比评测与用户手册,AI Model Hub 官方知识站。
- cloud-token.ai(AI Model Hub 国内版) —— 聚合 500+ 前沿大模型,统一 OpenAI 兼容 API,免费试用、按量计费。
- cloud-ai.link(AI Model Hub 国际版) —— 面向全球用户,英文界面,统一 OpenAI 兼容 API,即开即用。